게임 최적화에 대해 논할 때 가장 먼저, 그리고 가장 자주 등장하는 용어가 바로 ‘드로우 콜(Draw Call)’입니다. 게임 개발자라면 누구나 “드로우 콜을 줄여야 한다”는 이야기를 귀에 딱지가 앉도록 듣지만, 정작 이것이 정확히 무엇인지, 왜 이것이 많아지면 CPU 성능이 급격히 떨어지는지 소스 코드 레벨에서 이해하기는 어렵습니다.
이 글에서는 게임 최적화의 난제인 드로우 콜의 정의를 명확히 하고, CPU와 GPU 사이의 병목 현상을 소스 코드와 그래픽스 API 관점에서 완벽하게 분석해 보겠습니다.
1. 드로우 콜(Draw Call)이란 무엇인가?
드로우 콜은 아주 직관적으로 말해 CPU가 GPU에게 “이 메쉬(Mesh)와 material 정보를 바탕으로 화면에 그리라”고 명령하는 그래픽스 API 호출입니다.
유니티(Unity)나 언리얼(Unreal) 같은 게임 엔진에서 객체를 렌더링할 때 내부적으로는 아래와 같은 그래픽스 API 함수가 호출됩니다.
C#
// 유니티 엔진 내부에서 개별 오브젝트를 렌더링할 때 호출되는 대표적인 API 예시 (C#)
Graphics.DrawMesh(mesh, matrix, material, layer);
이 함수가 호출되면 CPU는 드라이버를 통해 GPU에 메쉬의 정점 데이터, 텍스처, 그리고 셰이더 상태를 전달하고 그리기를 지시합니다. 이때 드로우 콜 1회가 발생합니다.
2. 드로우 콜과 렌더링 상태(Rendering State) 변경 오버헤드
드로우 콜 자체가 무거운 것이 아니라, 드로우 콜 직전에 일어나는 ‘렌더링 상태(Rendering State) 변경’이 CPU에 막대한 부하를 줍니다.
예를 들어, 서로 다른 텍스처와 셰이더를 사용하는 1,000개의 오브젝트가 있다면 CPU는 매번 다음과 같은 상태 바인딩 작업을 반복해야 합니다.
C++
// C++ 기반 그래픽스 드라이버 레벨에서의 상태 변경 및 드로우 콜 의사 코드 (Pseudo Code)
for (int i = 0; i < objectCount; ++i) {
    // 1. 텍스처 바인딩 상태 변경 (오버헤드 발생)
    glBindTexture(GL_TEXTURE_2D, objects[i].textureID);

    // 2. 셰이더 프로그램 바인딩 변경 (오버헤드 발생)
    glUseProgram(objects[i].shaderProgramID);

    // 3. 실제 드로우 콜 실행
    glDrawElements(GL_TRIANGLES, objects[i].indexCount, GL_UNSIGNED_INT, 0);
}
이처럼 매번 다른 텍스처와 재질(Material)을 교체하며 그리는 과정이 반복되면 CPU는 상태 관리와 드라이버 통신에 연산력을 전부 소모하게 됩니다.
3. HLSL 셰이더와 배치(Batching) 관점에서의 최적화 원리
이러한 드로우 콜 부하를 줄이기 위해 게임 엔진들은 배칭(Batching)이나 GPU 인스턴싱(GPU Instancing) 기술을 사용합니다. 예를 들어, 동일한 메쉬를 여러 개 그릴 때는 GPU 인스턴싱을 통해 단 한 번의 드로우 콜로 수백 개의 객체를 처리할 수 있습니다.
이때 사용되는 HLSL(High-Level Shading Language) 셰이더 코드에서는 인스턴스 ID를 받아 각 객체의 위치를 개별 계산합니다.
High-level shader language
// HLSL을 이용한 GPU 인스턴싱 베이직 셰이더 코드 조각
cbuffer UnityPerDraw {
    float4x4 unity_ObjectToWorld;
};

// 인스턴스별 고유 데이터를 받기 위한 구조체
struct appdata {
    float4 vertex : POSITION;
    uint instanceID : SV_InstanceID; // GPU 인스턴스 식별자
};

struct v2f {
    float4 pos : SV_POSITION;
};

v2f vert(appdata v) {
    v2f o;
    // 다중 인스턴스의 월드 행렬을 적용하여 단일 드로우 콜로 처리
    float4 worldPos = mul(unity_ObjectToWorld, v.vertex);
    o.pos = mul(UNITY_MATRIX_VP, worldPos);
    return o;
}

float4 frag(v2f i) : SV_Target {
    return float4(1.0, 1.0, 1.0, 1.0); // 고정 색상 렌더링
}
이와 같이 코드로 렌더링 파이프라인의 상태 전환을 줄이고 데이터를 모아주는 것이 최적화의 핵심입니다.
4. CPU와 GPU 사이의 병목 현상 분석
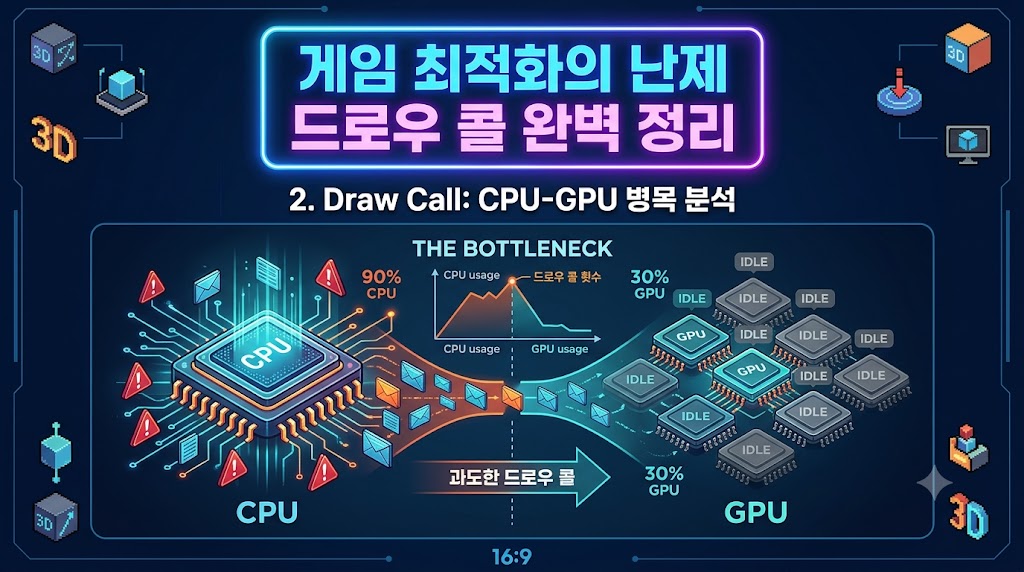
과도한 드로우 콜은 결국 CPU 병목(CPU Bottleneck)을 유발합니다.
- CPU의 한계: 드로우 콜을 유발하는 상태 데이터 세팅과 드라이버 호출은 싱글 코어 연산 의존도가 높기 때문에, 오브젝트가 많아지면 CPU가 이를 감당하지 못해 멈춤 현상(Stuttering)이 발생합니다.
- GPU의 유휴 상태: GPU는 병렬 처리가 뛰어나 수만 개의 폴리곤도 순식간에 처리할 수 있지만, CPU가 다음 드로우 콜 명령을 제때 보내주지 못하면 GPU는 일을 하지 못하고 대기(Idle) 상태에 빠집니다.
요약 및 결론
드로우 콜은 단순히 화면에 객체를 그리는 명령을 넘어, CPU가 GPU에게 매번 렌더링 상태를 주입하는 무거운 커뮤니케이션 과정입니다.
효과적인 게임 최적화를 위해서는 1) 머티리얼즈 아틀라스화를 통한 배칭, 2) GPU 인스턴싱 도입, 3) 불필요한 오브젝트 컬링을 통해 드로우 콜 수치를 최소화해야 하며, 이를 통해 CPU 병목을 해소하고 안정적인 프레임을 확보할 수 있습니다.