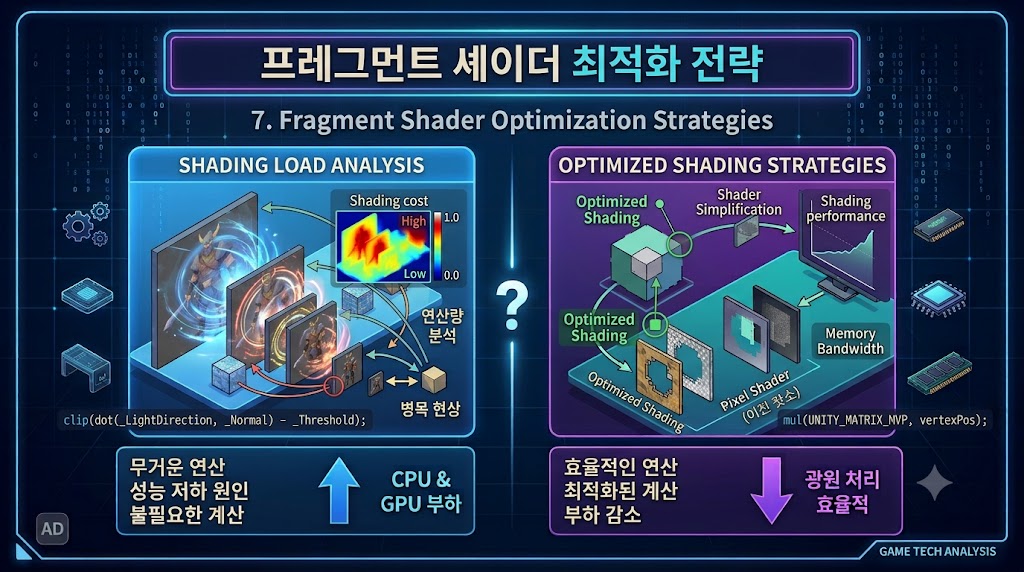
삼차원 게임의 그래픽 퀄리티를 결정하는 핵심 요소 중 하나는 화면에 그려지는 개별 픽셀의 색상과 질감을 계산하는 프레그먼트 셰이더입니다. 유니티 엔진 등에서는 이를 픽셀 셰이더로 부르기도 합니다. 화면의 해상도가 높아지고 셰이더 내부의 수학적 연산이나 텍스처 샘플링이 복잡해질수록, 그래픽 카드인 GPU의 픽셀 처리 부하는 기하급수적으로 증가하게 됩니다.
이 글에서는 프레그먼트 셰이더의 연산 비용이 게임 성능에 미치는 영향을 심층적으로 분석하고, 실제 셰이더 코드를 수정하여 성능을 극대화할 수 있는 구체적인 최적화 전략을 상세히 살펴보겠습니다.
1. 프레그먼트 셰이더 연산 부하의 구조적 원인
프레그먼트 셰이더는 래스터라이제이션 단계에서 생성된 모든 픽셀 후보군에 대해 개별적으로 실행됩니다. 따라서 화면 전체를 채우는 픽셀의 수인 필레이트가 높거나, 셰이더 내부의 수학적 연산이 복잡하면 성능 저하의 주원인이 됩니다.
주요 부하 발생 원인은 다음과 같이 요약할 수 있습니다.
첫째, 과도한 텍스처 샘플링입니다. 하나의 픽셀 색상을 결정하기 위해 여러 장의 베이스 텍스처, 노멀 맵, 스페큘러 맵 등을 동시에 읽어오는 경우 메모리 대역폭에 심각한 부하를 줍니다.
둘째, 복잡한 수학 함수의 남용입니다. 삼각함수, 벡터 내적 및 외적, 제곱근, 지수 연산 등은 GPU의 ALU(산술논리장치)를 소모하는 무거운 연산에 해당합니다.
셋째, 동적 광원 계산의 중첩입니다. 픽셀 단위로 수많은 광원과의 거리를 직접 계산하는 경우 연산량이 폭발적으로 증가합니다.
2. HLSL 셰이더 코드 최적화 구현 기법
셰이더 코드를 작성할 때 불필요한 연산을 줄이고 하드웨어 성능을 극대화할 수 있는 구체적인 코드 예시를 확인해 보겠습니다.
High-level shader language
// 최적화 전: 개별 스칼라 연산과 중복 코드가 포함된 비효율적인 셰이더
float4 badFrag(v2f i) : SV_Target {
    float dist1 = length(i.worldPos - _LightPos1);
    float dist2 = length(i.worldPos - _LightPos2);
    float val = sin(dist1) + cos(dist2);
    return float4(val, val, val, 1.0);
}

// 최적화 후: 벡터 내장 함수와 정밀도 조절, 내장 연산을 활용한 효율적인 셰이더
fixed4 goodFrag(v2f i) : SV_Target {
    // 모든 연산에 32비트 float 대신 16비트 half나 fixed를 사용하여 대역폭 절약
    half3 lightDir = _LightPos.xyz - i.worldPos;
    half atten = saturate(dot(lightDir, lightDir)); // GPU 최적화 내장 함수 활용
    return fixed4(atten, atten, atten, 1.0);
}
위의 최적화 코드에서 볼 수 있듯이, 모든 변수에 무조건 32비트 부동소수점을 사용하는 것보다 모바일이나 저사양 환경을 고려하여 16비트나 고정소수점 타입을 활용하는 것이 유리합니다. 또한 복잡한 삼각함수 대신 벡터의 내적과 saturate 같은 하드웨어 가속 내장 함수를 적극적으로 활용해야 합니다.
3. 조건문과 분기(Branching)에 따른 성능 영향
셰이더 내부에서 사용되는 조건문은 GPU의 병렬 처리 구조 특성상 성능 저하를 유발하는 주된 요인이 됩니다. GPU는 기본적으로 다수의 스레드가 동일한 명령어를 동시에 수행하는 SIMD 구조를 가집니다.
만약 셰이더 내부에서 조건에 따라 서로 다른 실행 경로로 갈라지는 분기가 발생하면, GPU는 양쪽 경로를 모두 연산한 뒤 결과적으로 필요한 값만 선택하는 방식을 취하게 됩니다.
High-level shader language
// 비효율적인 분기문 사용 예시 (성능 저하 유발 가능)
float4 frag(v2f i) : SV_Target {
    if (_UseAdvancedLighting > 0) {
        return ComplexLighting(i); // 무거운 연산 경로
    } else {
        return SimpleLighting(i);  // 가벼운 연산 경로
    }
}
따라서 분기문 대신 lerp 함수나 선형 보간 기법을 활용하여 조건문 없이 부드럽게 값을 전환하는 방식을 채택하는 것이 셰이더의 파이프라인 병목을 방지하는 지름길입니다.
요약 및 결론
프레그먼트 셰이더 최적화는 3D 게임의 프레임 레이트를 안정적으로 방어하기 위한 필수적인 기술적 과제입니다.
불필요한 텍스처 샘플링을 줄이고, 적절한 데이터 정밀도를 선택하며, 복잡한 분기문과 고비용 수학 함수의 사용을 최소화함으로써 GPU의 픽셀 처리 병목 현상을 효과적으로 해소할 수 있습니다. 이러한 미세한 코드 조율이 모여 전체 게임의 최적화 수준을 결정하게 됩니다.